ترسل صورة فاتورة إلى برنامج محادثة، فيقرأ أرقامها.
تتكلّم في هاتفك، فتتحوّل كلماتك إلى نص مكتوب.
تكتب وصفًا قصيرًا، فتحصل على صورة لم تكن موجودة.
لم يعد الذكاء الاصطناعي يتعامل مع النص وحده. فكيف يتعامل مع الصورة والصوت والفيديو؟ وأين يخطئ؟ هذا موضوع هذا الدرس.
في هذا الدرس
قبل أن تبدأ، فرّق بين أمرين ستراهما في الدرس كله:
- الفهم (Understanding): يأخذ النموذج صورة أو صوتًا موجودًا، فيصفه أو يقرأه أو يكتبه نصًا.
- التوليد (Generation): يأخذ النموذج وصفًا منك، فيصنع صورة أو صوتًا أو مقطعًا جديدًا.
الصور: الفهم وإنشاء صور
لا يرى النموذج الصورة كما تراها أنت. الصورة عنده أرقام: لكل نقطة صغيرة فيها رقم يمثّل لونها. وكثير من النماذج اليوم تقطّع الصورة إلى مربعات صغيرة، ثم تقرأ المربعات واحدًا بعد آخر، كما يقرأ النموذج اللغوي النص قطعة بعد قطعة.
تخيّل لوحة فسيفساء من قطع صغيرة. أنت ترى اللوحة كاملة. أما النموذج فيقرأ القطع، ويبحث فيها عن أنماط رآها كثيرًا في التدريب: هذه القطع معًا تشبه أذنَي قطة، وتلك تشبه حروفًا.
بهذا يستطيع النموذج أن يصف الصورة، ويقرأ النص المكتوب فيها، ويجيب عن أسئلتك عنها: ماذا في الصورة؟ ما المكتوب على اللافتة؟ كم المبلغ في الفاتورة؟
أما التوليد فطريقه مختلف. كثير من أدوات الصور تبدأ من صورة مليئة بالضجيج أو التشويش (Noise)، أي نقاط عشوائية لا معنى لها. ثم تزيل جزءًا من الضجيج في كل خطوة، بحسب الوصف الذي كتبته، حتى تظهر صورة واضحة. وهذا يشبه نحّاتًا يزيل الحجر الزائد شيئًا فشيئًا حتى يتشكّل التمثال.
سؤال سريع
طلبت من برنامج أن يقرأ لك المبلغ في صورة فاتورة. هل هذا فهم أم توليد؟
أظهر الإجابة
فهم. فالنموذج يقرأ صورة موجودة، ولا يصنع صورة جديدة.
الصوت: من الكلام إلى النص، ومن النص إلى الكلام
الصوت موجات، يحوّلها النموذج إلى أرقام كما يفعل بالصورة. ثم يعمل في اتجاهين:
- تحويل الكلام إلى نص: تتكلّم، فيكتب ما سمعه باللغة نفسها. وهذا يشبه كاتب محضر يدوّن ما يقال في اجتماع.
- تحويل النص إلى كلام: تكتب نصًا، فيقرأه بصوت يشبه صوت إنسان، بنطق ونبرة يختارهما.
وهنالك إمكانية ثالثة اسمها استنساخ الصوت (Voice Cloning):
- ما هو: يسمع النموذج عينات من صوت شخص، ثم يقرأ أي نص بصوت يشبهه.
- فائدته: يساعد مثلًا من فقد صوته بسبب المرض.
- خطره: يُستعمل في الاحتيال، كمكالمة بصوت يشبه صوت قريب لك، يطلب مالًا بسرعة.
سؤال سريع
وصلتك رسالة صوتية بصوت أخيك يطلب تحويل مبلغ فورًا. ماذا تفعل؟
أظهر الإجابة
لا تحوّل شيئًا قبل أن تتصل به أنت على رقمه المعروف، أو تسأله سؤالًا لا يعرف جوابه غيره. فالصوت وحده لم يعد دليلًا كافيًا.
الفيديو: صور متتابعة
الفيديو صور كثيرة متتابعة، ومعها صوت في الغالب. وهو يشبه دفترًا صغيرًا ترسم في كل صفحة منه الشخص نفسه بحركة مختلفة قليلًا، فإذا قلّبت الصفحات بسرعة رأيت حركة.
ويعمل النموذج مع الفيديو في اتجاهين أيضًا:
- الفهم (Understanding): يلخّص مقطعًا، أو يصف ما يحدث فيه.
- التوليد (Generation): يصنع مقطعًا قصيرًا من وصف تكتبه.
والصعب في التوليد أن يبقى كل شيء ثابتًا من صورة إلى التي تليها:
- الوجه نفسه.
- الملابس نفسها.
- الأشياء في أماكنها.
ولهذا أرى في مقاطع الفيديو المولّدة اليوم أشياء مضحكة:
- ممثلة لا تغيّر ملابسها أبدًا، مهما مرّت الأيام في القصة.
- ممثل يخرج من الغرفة، فيدخل في الجدار أو في الثلاجة.
- شخص يتكلّم بلغة، ثم ينتقل فجأة إلى لغة أخرى.
وفي رأيي، ما زال إنشاء الفيديو بالذكاء الاصطناعي غير جيد بما يكفي، وإن كان يتحسّن.
ولاحظ أن كثيرًا من البرامج اليوم تقبل أكثر من نوع في المحادثة نفسها: نصًا وصورة وصوتًا.
ويُسمّى النموذج الذي يفهم أكثر من نوع نموذجًا متعدد الوسائط (Multimodal).
لكن هذا لا يعني أن كل برنامج يستطيع صنع كل شيء، فبعضها يفهم الصور ولا يصنع الفيديو مثلًا.
ماذا وجدتُ حين جرّبتُ بنفسي؟
جرّبتُ في 13 أكتوبر 2026 ثلاث تجارب، في Gemini وChatGPT.
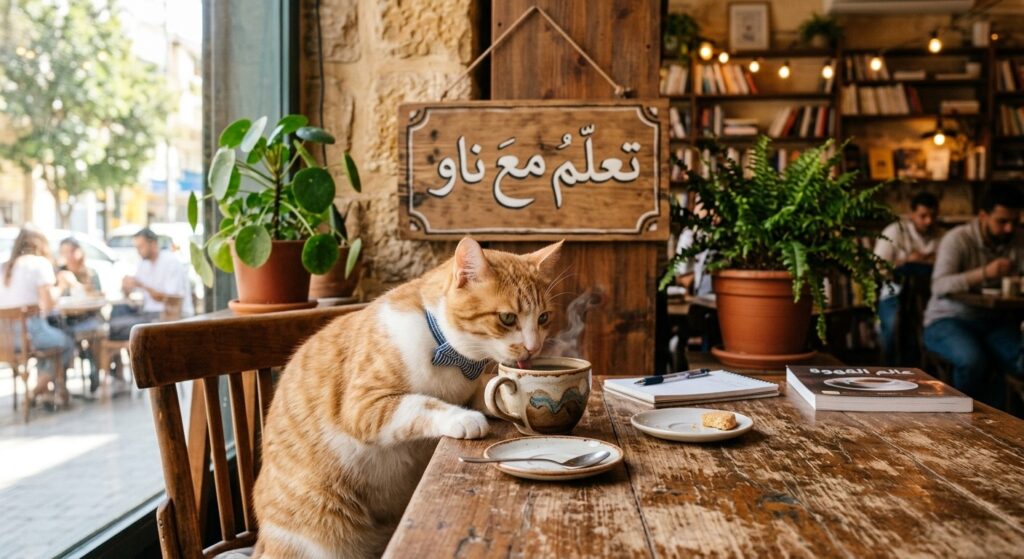
التجربة الأولى: إنشاء صورة. طلبتُ من Gemini صورة قطة تشرب القهوة، وفي الخلفية لافتة مكتوب عليها «تعلم مع ناو». جاءت الصورة جميلة، والحروف العربية صحيحة. لكن التشكيل أخطأ: كتب «تعلّمُ» بالضم، والصواب «تعلَّمْ» بالسكون، لأنه فعل أمر. ولاحظتُ أيضًا أن الفنجان خارج صحنه.
التجربة الثانية: من الكلام إلى النص. قلتُ هذه الجملة بالفصحى: «تعلمتُ قواعد البيانات مع ناو، وجرّبتُ استعلامات SQL في phpMyAdmin».
- Gemini، المرة الأولى: كتب «معنا» بدل «مع ناو».
- Gemini، المرة الثانية: كتب «مع نو».
- ChatGPT: كتب «مع الناو».
كتب البرنامجان الكلمات التقنية المشهورة صحيحة، مثل SQL وphpMyAdmin. لكنهما أخطآ في الاسم «ناو» في كل مرة، وبطريقة مختلفة كل مرة. والجملة في كل مرة تبدو سليمة تمامًا.
التجربة الثالثة: قراءة الصورة. أعطيتُ صورة القطة نفسها لـ Gemini ثم لـ ChatGPT، وطلبتُ من كل منهما أن يقرأ اللافتة كما هي بتشكيلها. فكتب الاثنان «تَعَلَّمْ» بالسكون. لكن اللافتة فيها «تعلّمُ» بالضم! لم يقرأ النموذج ما في الصورة، بل كتب ما يتوقّع أن يكون فيها.
ماذا تعلّمتُ من هذه التجارب؟ تحسّنت النماذج كثيرًا، ولم تعد أخطاؤها كبيرة. صارت تملأ الفراغ بما تتوقعه، لا بما هو موجود فعلًا. لذلك تبدو النتيجة سليمة، والخطأ مختبئ فيها.
وهذا يرتبط بما عرفته في درس كيف تُدرَّب النماذج؟: النموذج تعلّم الأنماط الشائعة. فالكلمة المشهورة يعرفها، والاسم النادر يستبدل به أقرب كلمة مشهورة.
سؤال سريع
لماذا كتب البرنامجان «phpMyAdmin» صحيحة، وأخطآ في «ناو»؟
أظهر الإجابة
لأن «phpMyAdmin» اسم مشهور تكرّر كثيرًا في بيانات التدريب، أما «ناو» فاسم نادر، فاستبدل به النموذج أقرب ما يعرفه.
كيف تتحقّق من صورة أو مقطع؟
صار صنع صورة أو صوت أو مقطع مزيَّف يبدو حقيقيًا أمرًا سهلًا. ويُسمّى هذا التزييف العميق (Deepfake). فإذا وصلتك صورة أو مقطع يثير غضبك أو خوفك، أو يدفعك إلى تصرّف ما، فتوقّف قبل أن تصدّقه أو تنشره:
- ابحث عن المصدر: من نشره أولًا؟ وهل نشرته جهة موثوقة أخرى؟
- ابحث بالصورة نفسها: البحث العكسي عن الصور، مثل Google Lens، قد يدلّك على أصلها أو على نسخة أقدم منها.
- انظر إلى التفاصيل بتمعّن: النص المكتوب، والأيدي، والظلال، والأشياء في الخلفية. وتذكّر أن الأخطاء صارت صغيرة، كحركة في كلمة.
- لا تعتمد على علامة واحدة: بعض الأدوات تضع علامة مخفية في ما تصنعه، لكن هذه العلامة قد تُحذف، فغيابها لا يثبت أن الصورة حقيقية.
وستعرف في درس كيف يُستخدم ضدك؟ كيف يستعمل المحتالون الأصوات والمقاطع المزيفة، وكيف تحمي نفسك وعائلتك منها.
جرّبه الآن
افتح برنامج محادثة على هاتفك، مثل ChatGPT أو Gemini، واضغط زر الميكروفون، ثم قل جملة فيها اسمك واسم مدينتك أو شارعك. أو قل هذه الجملة:
تعلمتُ قواعد البيانات مع ناو، وجرّبتُ استعلامات SQL في phpMyAdmin.
ماذا تلاحظ؟ قارن النص الذي كتبه بما قلته، كلمة كلمة. هل حذف كلمة؟ هل استبدل باسم نادر كلمة مشهورة؟ وهل كنت ستلاحظ الخطأ لو لم تقارن؟
كيف تطبّق هذا؟
- حين يحوّل البرنامج كلامك إلى نص، راجع الأسماء والأرقام قبل أن ترسل النص.
- حين يقرأ لك صورة، كفاتورة أو مستند، قارن الأرقام المهمة بالصورة نفسها.
- حين تصنع صورة فيها كتابة عربية، راجع الحروف والتشكيل بنفسك.
- لا تصدّق صوتًا أو صورة أو مقطعًا يطلب منك مالًا أو قرارًا سريعًا، قبل أن تتحقّق بطريقة أخرى.
الخلاصة
- يحوّل النموذج الصورة والصوت إلى أرقام، ثم يبحث فيها عن أنماط. وهو يفهم ما هو موجود، ويصنع ما هو جديد.
- تحسّنت النماذج كثيرًا، ولم تعد أخطاؤها كبيرة. صارت تملأ الفراغ بما تتوقعه، لا بما هو موجود فعلًا.
- لذلك قارن بالأصل كلمة كلمة، ولا تصدّق صوتًا أو صورة وحدهما حين يكون الأمر مهمًا.
اختبر نفسك
1. كيف يقرأ النموذج الصورة؟
أ) يراها كما يراها الإنسان تمامًا.
ب) يحوّلها إلى أرقام، ويبحث فيها عن أنماط رآها في التدريب.
ج) يبحث عنها في الويب ويقرأ وصفها.
د) يحفظ كل صورة رآها في التدريب.
2. قلتَ لبرنامج جملة فيها اسمك، فكتب الجملة سليمة لكن الاسم تغيّر إلى كلمة مشهورة. لماذا؟
أ) لأن الميكروفون معطّل.
ب) لأن النموذج يكمل بما يتوقّعه، والاسم النادر قليل في بيانات تدريبه.
ج) لأنه لا يفهم العربية أبدًا.
د) لأنه يتعمّد تغيير الأسماء.
3. وصلك مقطع صوتي بصوت مديرك يطلب تحويل مبلغ عاجل. ما التصرف الصحيح؟
أ) تحوّل المبلغ؛ لأن الصوت صوته.
ب) تعيد سماع المقطع مرتين ثم تحوّل.
ج) تتصل بمديرك على رقمه المعروف وتتأكّد قبل أي تحويل.
د) ترسل المقطع إلى برنامج محادثة ليحكم عليه.
أظهر الإجابات
1) ب 2) ب 3) ج